

 Menu
LiDAR vs vSLAM w robotach sprzątających – laser czy kamera? Co naprawdę działa lepiej?
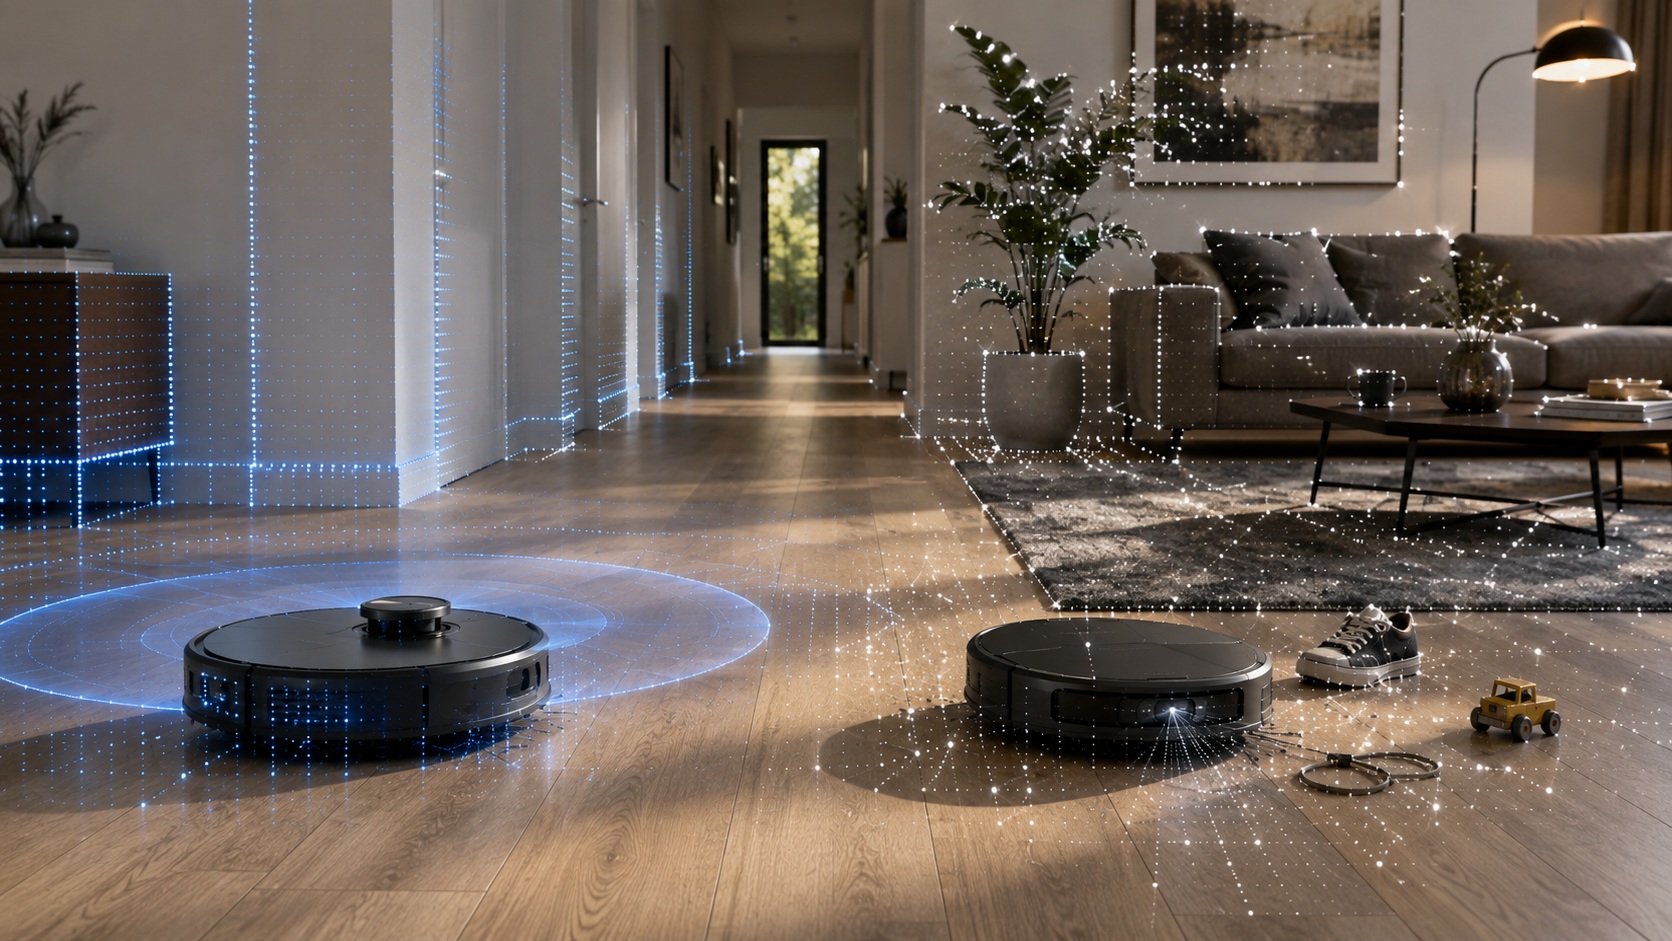
LiDAR mierzy geometrię otoczenia za pomocą światła, a vSLAM próbuje określić ruch i położenie robota na podstawie kolejnych obrazów z kamery. Laser zwykle lepiej radzi sobie bez oświetlenia i nie potrzebuje tekstury ścian, natomiast kamera dostarcza znacznie bogatszej informacji o wyglądzie otoczenia. Nie oznacza to jednak, że jeden system jest po prostu lepszy od drugiego – ich słabe strony są na tyle różne, że współczesne roboty coraz częściej łączą oba podejścia.
Jeszcze kilka lat temu podział robotów sprzątających wydawał się dość prosty.
Jedne miały charakterystyczną wieżyczkę laserową, inne kamerę.
I stąd do dziś bierze się bardzo popularne pytanie:
co jest lepsze – LiDAR czy vSLAM?
Problem polega na tym, że już samo porównanie nie jest do końca symetryczne.
LiDAR jest sensorem, natomiast vSLAM opisuje sposób jednoczesnej lokalizacji i mapowania z wykorzystaniem danych wizyjnych.
Bardziej technicznie powinniśmy więc porównywać:
- LiDAR SLAM – lokalizację i mapowanie oparte przede wszystkim na pomiarach laserowych,
- Visual SLAM – lokalizację i mapowanie wykorzystujące obrazy z kamery.
To rozróżnienie jest ważne, bo sam LiDAR również nie tworzy mapy. Jak wyjaśnialiśmy wcześniej, LiDAR przede wszystkim dostarcza pomiarów otoczenia, a dopiero SLAM próbuje z tych danych zbudować mapę i określić położenie robota.
W przypadku vSLAM zamiast kolejnych skanów laserowych głównym źródłem informacji stają się kolejne obrazy.
LiDAR i kamera patrzą na mieszkanie zupełnie inaczej
Najprostsza różnica jest jednocześnie najważniejsza.
LiDAR przede wszystkim mierzy geometrię.
Kamera przede wszystkim rejestruje obraz.
Jeżeli laserowy dalmierz zwróci punkt znajdujący się 1,8 metra od robota, mamy bezpośrednią informację o odległości zmierzonej przez sensor.
W obrazie z pojedynczej zwykłej kamery nie ma takiej wartości zapisanej wprost.
Widzimy piksele.
Algorytm musi dopiero wykorzystać ich zmianę pomiędzy kolejnymi klatkami, geometrię kamery i dodatkowe informacje, aby oszacować ruch oraz strukturę otoczenia.
| LiDAR | Kamera | |
|---|---|---|
| Podstawowa informacja | Odległość i geometria | Obraz i jego cechy wizualne |
| Kolor i tekstura | Bardzo ograniczona informacja | Bogata informacja |
| Pomiar odległości | Bezpośredni pomiar sensorem | W klasycznej kamerze monocularnej odległość trzeba oszacować |
| Zależność od światła widzialnego | Zwykle niewielka | Duża w klasycznej kamerze RGB |
| Rozpoznawanie rodzaju przedmiotu | Ograniczone bez dodatkowej analizy | Duży potencjał przy wykorzystaniu computer vision i AI |
Już na tym poziomie widać, że oba sensory dostarczają robotowi innego rodzaju informacji.
Co właściwie oznacza vSLAM?
vSLAM to Visual Simultaneous Localization and Mapping – jednoczesna lokalizacja i mapowanie oparte na danych wizyjnych.
Robot próbuje rozwiązać dokładnie ten sam podstawowy problem, który poznaliśmy przy klasycznym SLAM-ie:
gdzie jestem i jak wygląda otoczenie?
Tyle że zamiast obracającego się skanera laserowego może wykorzystywać jedną lub więcej kamer.
W literaturze spotkamy między innymi:
- monocular visual SLAM – z jedną kamerą,
- stereo visual SLAM – z dwiema kamerami,
- RGB-D SLAM – z obrazem i informacją o głębokości,
- visual-inertial SLAM – łączący kamerę z IMU.
Dlatego samo hasło „vSLAM” również nie opisuje jednej konkretnej konstrukcji.
Jak robot może określić ruch na podstawie obrazu?
Wyobraźmy sobie, że robot wykonuje zdjęcie pokoju.
W obrazie znajdują się:
- róg obrazu wiszącego na ścianie,
- krawędź szafki,
- fragment lampy,
- narożnik drzwi,
- wzór na meblu.
Robot przesuwa się o kilkanaście centymetrów i wykonuje kolejny obraz.
Te same elementy znajdują się teraz w innych miejscach kadru.
Jeżeli algorytm potrafi ustalić, że punkt widoczny w pierwszej klatce odpowiada temu samemu elementowi w drugiej, może zacząć odtwarzać ruch kamery względem otoczenia.
To trochę tak, jakby robot obserwował, jak świat przesuwa się wokół niego, i na tej podstawie wnioskował o własnym ruchu.
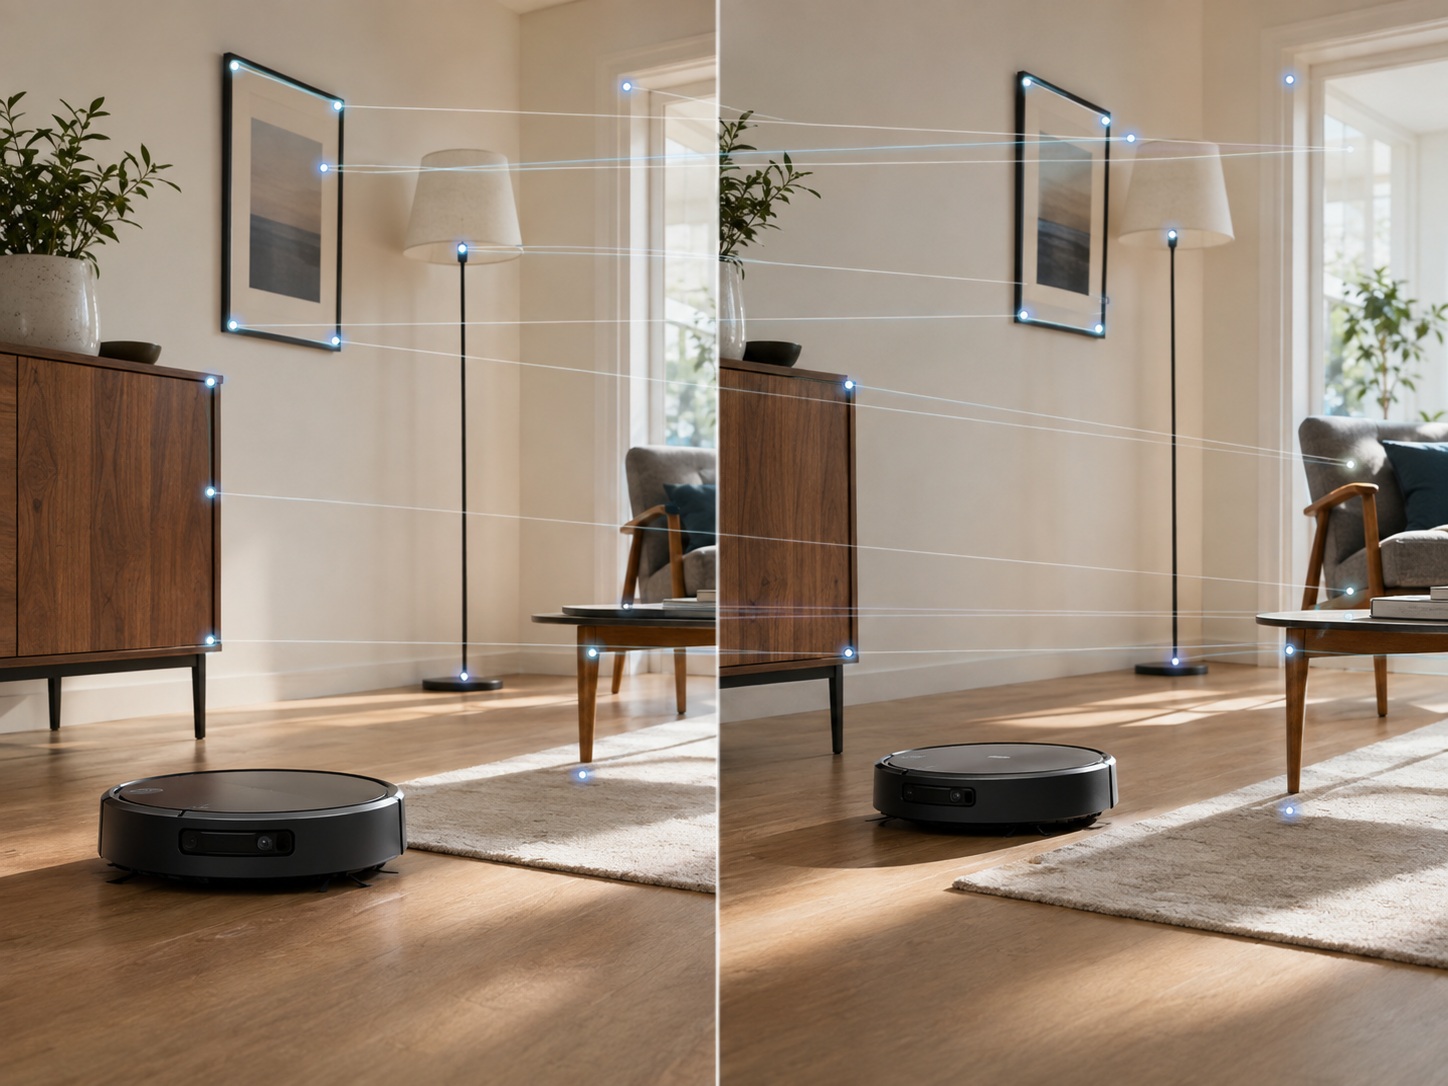
vSLAM może śledzić ruch robota poprzez analizę kolejnych obrazów i dopasowywanie tych samych cech wizualnych, takich jak narożniki mebli, framugi drzwi czy krawędzie przedmiotów.
Feature detection – robot szuka charakterystycznych miejsc obrazu
Jednym z klasycznych podejść Visual SLAM jest wykrywanie charakterystycznych cech obrazu.
Nie każda część zdjęcia nadaje się do tego równie dobrze.
Duża, jednolicie biała ściana może zawierać bardzo mało użytecznych informacji.
Narożnik ramy obrazu jest znacznie ciekawszy.
Podobnie:
- krawędzie,
- narożniki,
- lokalne wzory,
- kontrastowe fragmenty.
Algorytm może znaleźć takie punkty w jednej klatce i próbować odnaleźć je ponownie w kolejnej.
Feature matching – czy to na pewno ten sam punkt?
Samo znalezienie charakterystycznych miejsc nie wystarczy.
Trzeba jeszcze ustalić, które punkty z dwóch obrazów odpowiadają sobie nawzajem.
Jeżeli robot prawidłowo połączy:
punkt A w klatce pierwszej → punkt A w klatce drugiej,
punkt B → punkt B,
punkt C → punkt C,
może wykorzystać całą geometrię tych zmian do estymacji ruchu kamery.
To jeden z fundamentów klasycznych systemów feature-based Visual SLAM.
ORB-SLAM pokazuje, jak dużo można zrobić z samych cech obrazu
Jednym z najbardziej znanych systemów badawczych Visual SLAM jest ORB-SLAM.
Wykorzystuje charakterystyczne cechy obrazu między innymi do:
- śledzenia pozycji kamery,
- lokalnego mapowania,
- ponownej lokalizacji,
- rozpoznawania zamknięcia pętli.
System operuje również na kluczowych klatkach i optymalizuje jednocześnie pozycje kamery oraz elementy mapy.
Nie oznacza to oczywiście, że konkretny robot sprzątający korzysta z ORB-SLAM.
To przykład naukowy pokazujący mechanizmy występujące w rozwiniętych systemach Visual SLAM. Algorytmy stosowane przez producentów robotów są zazwyczaj rozwiązaniami własnymi i ich szczegóły nie są publiczne.
Nie każdy vSLAM szuka punktów
To również ważne uproszczenie.
Visual SLAM nie musi zawsze działać według schematu:
„znajdź narożniki → dopasuj narożniki”.
Istnieją również metody bezpośrednie, które wykorzystują informacje o intensywności pikseli i próbują dopasowywać obrazy bez klasycznego wykrywania zestawu charakterystycznych punktów.
Są też rozwiązania półbezpośrednie oraz coraz bardziej rozbudowane systemy wykorzystujące uczenie maszynowe.
Dlatego zdanie:
„vSLAM zawsze działa przez rozpoznawanie punktów charakterystycznych”
byłoby takim samym uproszczeniem jak stwierdzenie, że każdy LiDAR mierzy odległość dokładnie w ten sam sposób.
Jedna kamera ma jeszcze jeden problem: skala
Przy klasycznym LiDAR-ze odległość podawana jest w jednostkach fizycznych.
Sensor może poinformować system, że ściana znajduje się przykładowo 2,1 metra od urządzenia.
W przypadku pojedynczej kamery sytuacja jest trudniejsza.
Z samej geometrii kolejnych obrazów kamera monocularna może mieć problem z ustaleniem absolutnej skali świata.
Algorytm może odtworzyć strukturę i ruch, ale nie zawsze wie wyłącznie z obrazu, czy przesunięcie odpowiada 10 cm, czy na przykład 20 cm.
W prawdziwym robocie problem można ograniczać dodatkowymi informacjami:
- odometrią kół,
- IMU,
- znaną geometrią urządzenia,
- innymi sensorami odległości.
To kolejny powód, dla którego rzeczywisty robot rzadko powinien być rozpatrywany jako „sama kamera”.
LiDAR ma w tym miejscu dużą przewagę
Klasyczny LiDAR zaczyna od czegoś, czego pojedyncza kamera nie ma:
bezpośredniej informacji o odległości.
Po pełnym skanie robot może uzyskać geometryczny przekrój otoczenia zawierający położenie:
- ścian,
- framug,
- dużych mebli,
- innych powierzchni znajdujących się w płaszczyźnie skanowania.
Nie musi najpierw rozpoznawać koloru tapety czy charakterystycznego narożnika obrazu.
To właśnie dlatego LiDAR jest bardzo wygodnym sensorem do lokalizacji w pomieszczeniach.
Najlepszy przykład: duża biała ściana
Wyobraźmy sobie długą, całkowicie białą ścianę.
Nie ma na niej:
- obrazów,
- kontaktów,
- półek,
- wzorów,
- wyraźnych zmian koloru.
Dla feature-based vSLAM może to być niezbyt atrakcyjny fragment obrazu.
Brakuje charakterystycznych elementów, które można stabilnie śledzić pomiędzy kolejnymi klatkami.
LiDAR nadal może jednak otrzymywać bardzo czytelne pomiary od powierzchni ściany.
Laser nie potrzebuje wzoru na ścianie, żeby zmierzyć jej geometrię.
Ale pusty korytarz potrafi być trudny również dla LiDAR-u
Tu pojawia się ważne „ale”.
Wyobraźmy sobie bardzo długi korytarz z dwiema równoległymi ścianami.
LiDAR świetnie określa odległość od lewej i prawej ściany.
Ale jeżeli geometria korytarza na kolejnych metrach jest niemal identyczna, znacznie trudniej na podstawie samego skanu określić dokładną pozycję wzdłuż jego osi.
To przykład tak zwanej degeneracji geometrycznej – otoczenie może dostarczać dużo pomiarów, ale za mało unikalnej informacji w jednym kierunku.
Dlatego również LiDAR SLAM korzysta z:
- odometrii,
- IMU,
- kolejnych skanów,
- charakterystycznej geometrii otoczenia.
Duża liczba punktów pomiarowych nie zawsze oznacza dużą ilość informacji o pozycji.
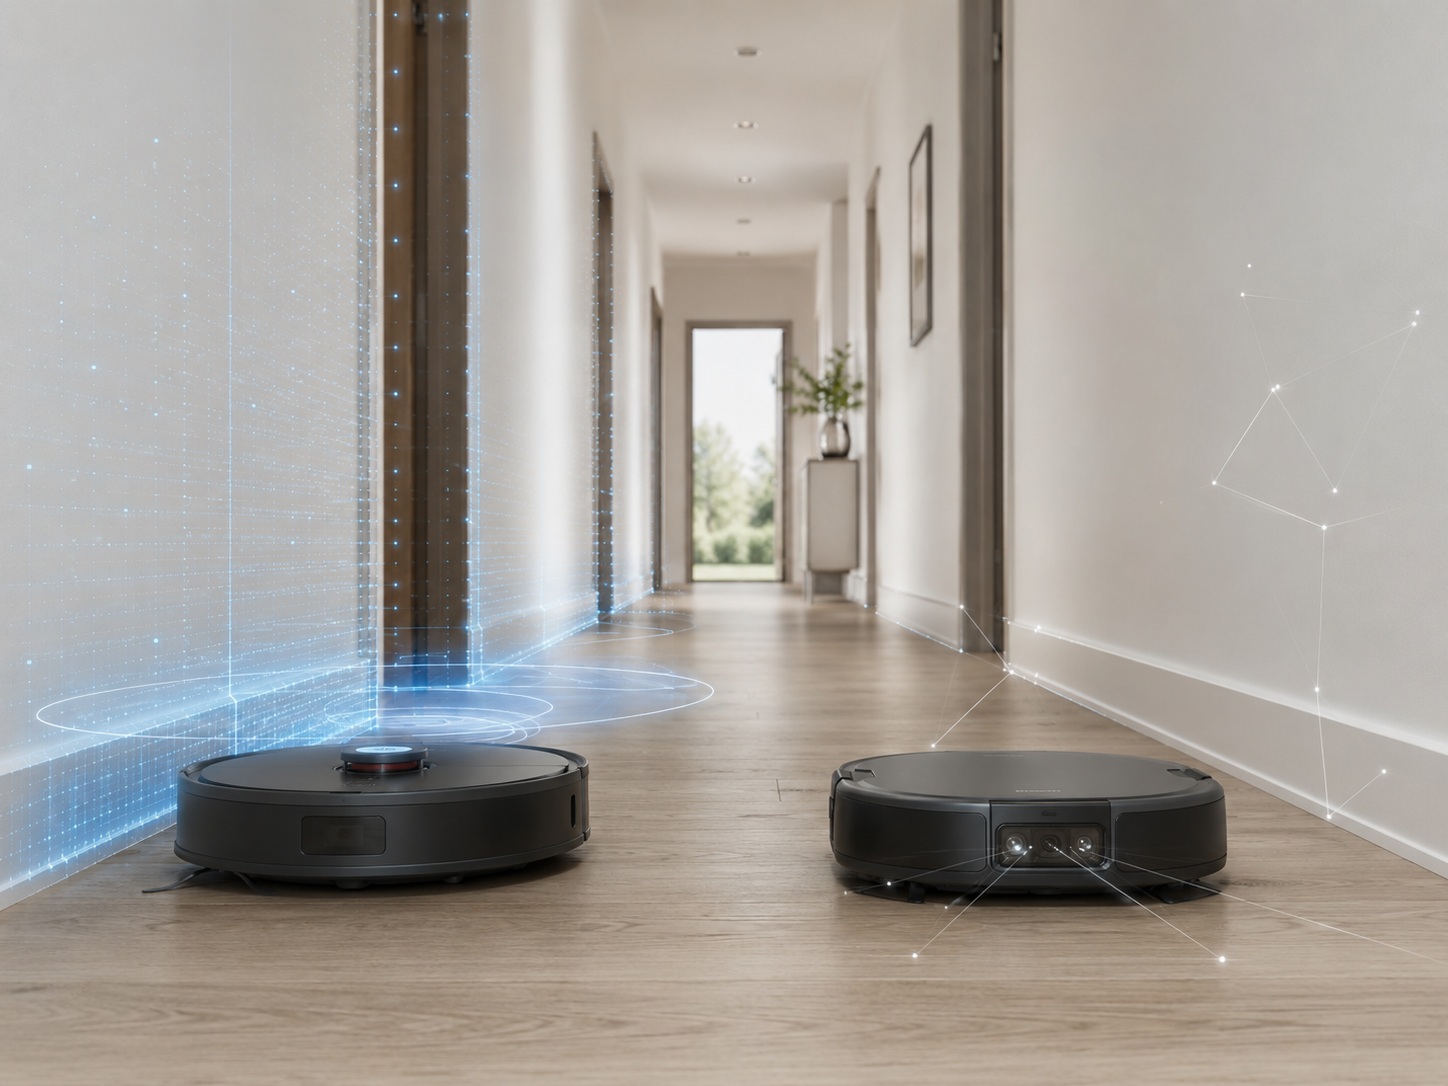
Jednolita biała ściana może dostarczać mało użytecznych cech wizualnych dla systemu vSLAM, podczas gdy LiDAR nadal mierzy geometrię. Z kolei długi, powtarzalny korytarz bywa wyzwaniem również dla lokalizacji opartej głównie na geometrii.
A teraz pokój pełen przedmiotów
Odwróćmy sytuację.
Na podłodze znajdują się:
- but,
- przewód USB,
- skarpetka,
- zabawka,
- miska zwierzęcia.
Klasyczny 2D LDS skanuje poziomą płaszczyznę znajdującą się kilka centymetrów nad podłogą.
Jeżeli kabel leży poniżej tej płaszczyzny, główny LiDAR może go po prostu nie przeciąć.
Kamera skierowana na przestrzeń przed robotem może natomiast zarejestrować kabel w obrazie.
Jeżeli system computer vision został nauczony rozpoznawania przewodów, ma szansę zidentyfikować go jako konkretny rodzaj przeszkody.
I właśnie tutaj pojawia się ogromna przewaga informacji wizualnej: kamera może dostarczać nie tylko geometrię, ale również wygląd obiektu.
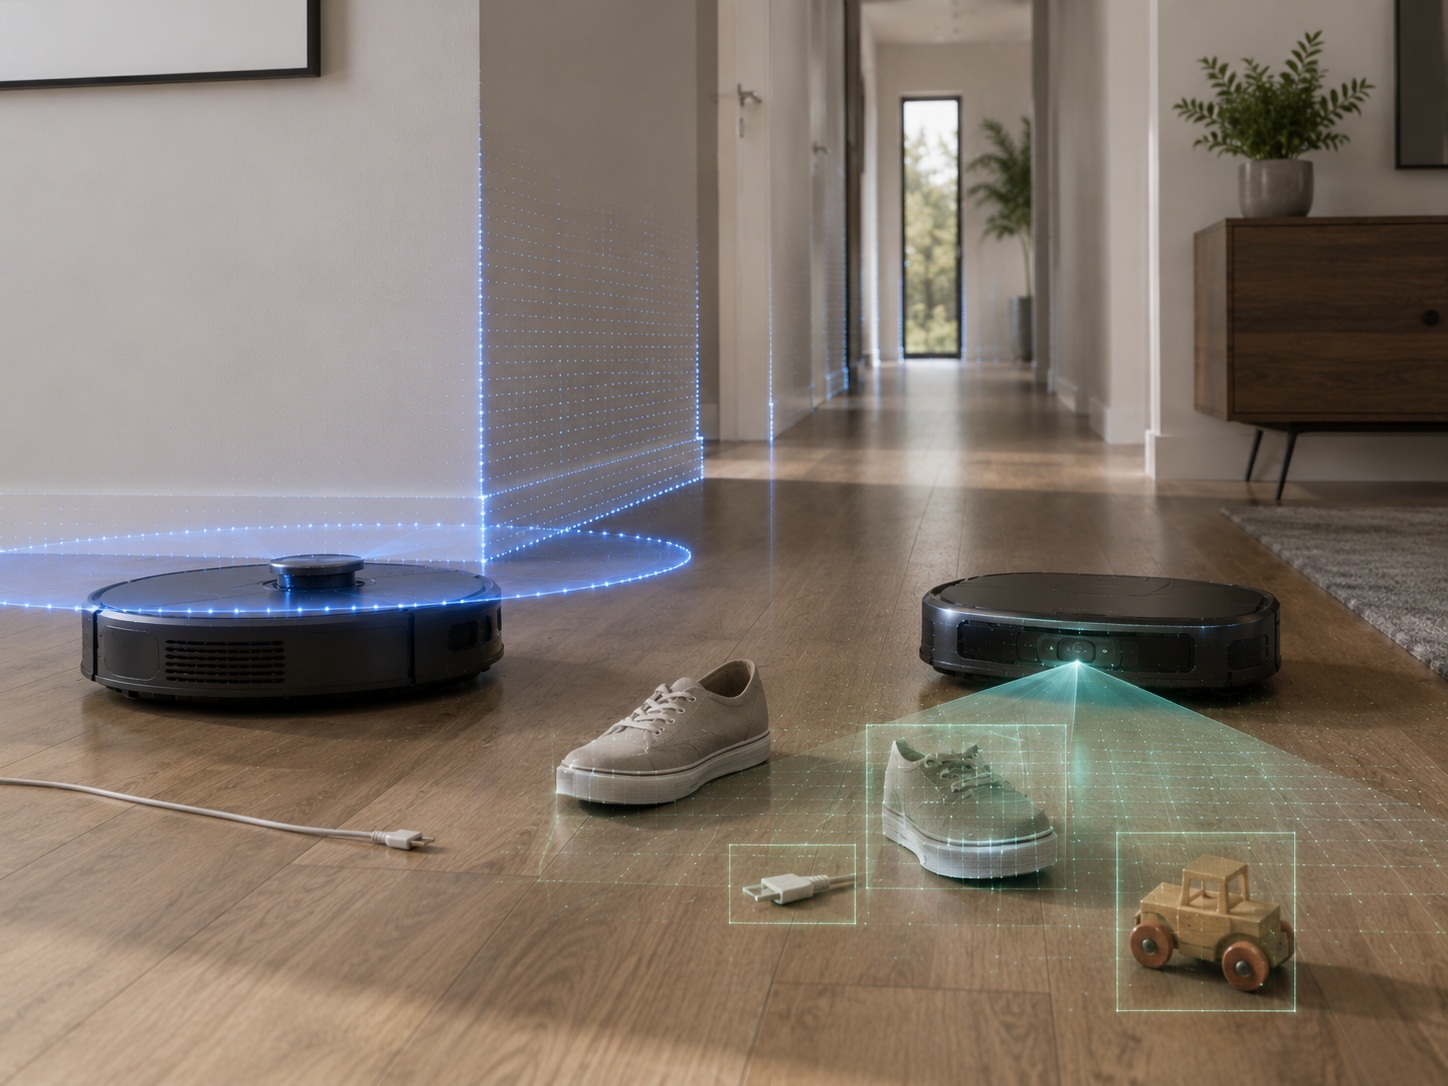
Klasyczny poziomy skan LDS nie zawsze zbiera pełną informację o bardzo niskich przeszkodach leżących na podłodze. Kamera skierowana przed robota może zarejestrować ich wygląd i położenie w obrazie.
Ważne: vSLAM i rozpoznawanie przedmiotów to nie to samo
Trzeba jednak bardzo wyraźnie rozdzielić dwa pojęcia.
vSLAM nie oznacza automatycznie rozpoznawania skarpetek, kabli czy odchodów zwierząt.
Visual SLAM odpowiada przede wszystkim za lokalizację i mapowanie.
Rozpoznawanie:
„to jest but”
albo:
„to jest przewód”
należy do warstwy percepcji i computer vision.
Może korzystać z tej samej kamery, ale wykonuje inne zadanie.
To szczególnie ważne przy współczesnych specyfikacjach, w których producent potrafi umieścić obok siebie hasła:
- kamera RGB,
- AI obstacle avoidance,
- Visual Recognition,
- LiDAR navigation.
Nie oznacza to, że kamera odpowiada za główną lokalizację robota.
Czy vSLAM działa w całkowitej ciemności?
Klasyczny vSLAM oparty na zwykłej kamerze RGB potrzebuje wystarczającej ilości światła, aby obraz zawierał użyteczne informacje.
Jeżeli kamera widzi praktycznie czarną klatkę, algorytm nie ma czego śledzić.
Przy słabym oświetleniu pojawiają się dodatkowo problemy takie jak:
- większy szum obrazu,
- mniejszy kontrast,
- gorsza detekcja cech,
- dłuższa ekspozycja,
- większe ryzyko motion blur podczas ruchu.
Dlatego ogólnie systemy wizyjne są bardziej zależne od warunków oświetleniowych niż klasyczny LiDAR.
Historia Roomby bardzo dobrze to pokazuje
iRobot był jednym z najważniejszych producentów, którzy przez lata rozwijali nawigację opartą na obrazie.
W Roomba 980 firma po raz pierwszy zastosowała w swoim produkcie konsumenckim własną technologię vSLAM w ramach iAdapt 2.0 Navigation with Visual Localization.
Robot wykorzystywał kamerę do obserwowania charakterystycznych elementów otoczenia i śledzenia własnej pozycji podczas sprzątania.
W kolejnych generacjach iAdapt 3.0 oraz Imprint Smart Mapping kamera nadal była wykorzystywana do identyfikowania wizualnych punktów orientacyjnych.
iRobot wymienia w swoich materiałach przykładowo:
- ramy obrazów,
- okna,
- wentylatory sufitowe,
- źródła światła
jako elementy pomagające robotowi w lokalizacji.
Starsze Roomby z vSLAM naprawdę potrzebowały światła
Nie jest to wyłącznie teoretyczna wada Visual SLAM.
W dokumentacji dla kamerowych modeli Roomba iRobot zalecał zapewnienie odpowiedniego oświetlenia podczas pracy robota.
Producent wskazywał, że ciemne pomieszczenia mogą utrudniać działanie kamery lokalizacyjnej.
Nie trzeba było oczywiście oświetlać pokoju jak planu filmowego – nawet przygaszone światło mogło wystarczyć – ale pełna ciemność była inną sytuacją niż w robocie wykorzystującym LiDAR.
Dlaczego LiDAR może pracować po ciemku?
LiDAR jest aktywnym sensorem.
Nie czeka na światło widzialne odbijające się od lampy czy słońca – emituje własne promieniowanie i analizuje jego powrót.
Dlatego zgaszenie światła w pokoju nie powoduje, że ściana nagle przestaje istnieć w danych laserowego dalmierza.
To jedna z najbardziej praktycznych zalet LiDAR-u w robocie sprzątającym.
Nie oznacza to, że każdy sensor optyczny jest całkowicie odporny na wszystkie warunki oświetleniowe. Aktywne systemy podczerwieni również mogą mieć swoje ograniczenia, a silne zewnętrzne promieniowanie może wpływać na niektóre pomiary.
Ale zależność od zwykłego oświetlenia pomieszczenia jest zupełnie inna niż w przypadku klasycznej kamery RGB.
„Kamera nie działa po ciemku” też jest dziś zbyt prostym stwierdzeniem
Współczesny robot nie musi korzystać wyłącznie z biernej kamery.
Może mieć:
- własne diody LED,
- oświetlenie podczerwone,
- światło strukturalne 3D,
- sensor ToF,
- LiDAR pracujący równolegle z kamerą.
Dlatego pytanie powinno brzmieć:
jak działa cały system percepcji konkretnego robota w ciemności?
a nie:
„czy ma kamerę?”.
Zmiany oświetlenia też potrafią oszukać vSLAM
Problemem nie musi być wyłącznie brak światła.
Wyobraźmy sobie ten sam salon:
- rano przy zasłoniętych roletach,
- w południe przy ostrym słońcu,
- wieczorem przy ciepłym świetle lampy.
Dla człowieka to nadal ten sam pokój.
Wartości pikseli na obrazie mogą jednak zmienić się bardzo mocno.
Dobry Visual SLAM musi być odporny na takie zmiany, ale literatura nadal wymienia gwałtowne zmiany oświetlenia jako jeden z problemów systemów wizyjnych.
Motion blur – robot skręca, kamera rozmazuje obraz
Robot sprzątający porusza się stosunkowo wolno, ale często wykonuje gwałtowne obroty.
Jeżeli przy słabym świetle kamera musi wydłużyć ekspozycję, ruch urządzenia może spowodować rozmycie obrazu.
Dla algorytmu oznacza to mniej czytelne:
- krawędzie,
- narożniki,
- tekstury,
- punkty charakterystyczne.
To kolejny przykład problemu, którego klasyczny skaner odległości doświadcza w zupełnie inny sposób.
Powtarzalne otoczenie również może być problemem dla kamery
Wyobraźmy sobie korytarz hotelowy:
- identyczne drzwi,
- identyczne lampy,
- powtarzający się wzór tapety,
- podobne fragmenty ścian.
Dla systemu rozpoznawania miejsc różne obszary mogą wyglądać bardzo podobnie.
Visual SLAM musi wtedy uniknąć błędnego uznania:
„już tutaj byłem”,
jeżeli w rzeczywistości robot znajduje się kilka metrów dalej.
To szczególnie istotne przy relokalizacji i loop closure.
A lustra i szkło – kamera wygra?
Niekoniecznie.
W poprzednim artykule pokazaliśmy szczegółowo, dlaczego lustra i szkło potrafią powodować błędne pomiary LiDAR-u.
Kamera dostaje przy tych powierzchniach inny problem.
W lustrze widzi bardzo przekonujący obraz przestrzeni.
Szyba może wyglądać niemal jak otwarte przejście.
Odbicia mogą tworzyć cechy wizualne, które pozornie znajdują się w innym miejscu.
Fizyka powierzchni refleksyjnych jest problemem zarówno dla lasera, jak i dla obrazu – tylko błędy powstają w inny sposób.
Kamera ma jednak jednego asa: kontekst
Obraz zawiera znacznie bogatszą informację semantyczną.
Algorytm computer vision może próbować zauważyć:
- ramę lustra,
- ramę szklanych drzwi,
- klamkę,
- odbicie,
- rodzaj przedmiotu.
Sam klasyczny punkt LiDAR-u nie zawiera informacji:
„jestem odbiciem szafy w lustrze”.
Dlatego połączenie geometrii z analizą obrazu może być znacznie potężniejsze niż każde z tych źródeł osobno.
LiDAR nie wie, że widzi but. Kamera może próbować to rozpoznać
Wyobraźmy sobie punkt znajdujący się 40 cm przed robotem.
LiDAR może bardzo dokładnie określić:
„w tym miejscu znajduje się powierzchnia”.
Ale z samej informacji o odległości trudno odpowiedzieć:
„co to jest?”
Kamera RGB może dostarczyć informacji o:
- kolorze,
- teksturze,
- kształcie,
- wyglądzie obiektu.
Model wizyjny może następnie próbować sklasyfikować obiekt jako:
- but,
- przewód,
- zabawkę,
- odchody zwierzęcia.
Właśnie dlatego kamery wróciły do wielu robotów, które jednocześnie używają LiDAR-u jako głównego źródła danych nawigacyjnych.
Roborock dobrze pokazuje tę zmianę
Roborock przez lata mocno kojarzył się z nawigacją laserową.
Producent podaje, że we wrześniu 2016 roku rozpoczął masową produkcję systemu nawigacyjnego opartego na LDS.
Dzisiaj sytuacja jest znacznie bardziej skomplikowana.
Przykładowo w Roborock S8 MaxV Ultra główna nawigacja laserowa współpracuje z systemem Reactive AI 2.0 wykorzystującym:
- kamerę RGB,
- światło strukturalne 3D.
Kamera może wspierać rozpoznawanie rodzaju przeszkody, a sensory przestrzenne dostarczają danych o jej geometrii.
To już nie jest prosty pojedynek:
laser kontra kamera.
Dreame robi właściwie to samo
Dobrym przykładem jest Dreame X50 Ultra.
Za główną nawigację odpowiada system VersaLift DToF.
Jednocześnie robot wykorzystuje:
- kamerę AI RGB,
- światło strukturalne 3D,
- dodatkowe oświetlenie pomagające przy słabszych warunkach.
Producent wykorzystuje więc różne sensory do różnych zadań.
LiDAR/dToF może dostarczać danych potrzebnych do lokalizacji i mapowania, podczas gdy kamera i system 3D pomagają analizować przestrzeń bezpośrednio przed robotem.
iRobot wykonał ruch w przeciwną stronę
Historia iRobot jest tutaj szczególnie ciekawa.
Firma przez lata rozwijała zaawansowane roboty wykorzystujące vSLAM i kamerę do lokalizacji.
W 2025 roku zaprezentowała jednak nową generację Roomb wyposażonych w ClearView LiDAR.
W modelach z wyższej półki LiDAR został dodatkowo połączony z PrecisionVision AI.
Trend był kontynuowany w generacji 2026, gdzie producent stosuje ClearView Pro LiDAR i PrecisionVision AI w bardziej zaawansowanych konstrukcjach.
To nie jest dowód, że vSLAM „przegrał”.
Znacznie ciekawszy jest inny wniosek:
producent, który przez lata był jednym z najbardziej znanych zwolenników nawigacji wizyjnej, również przeszedł w stronę systemów łączących pomiar przestrzeni z wizją komputerową.
LiDAR vs vSLAM – porównanie najważniejszych różnic
| Cecha | LiDAR / LiDAR SLAM | vSLAM |
|---|---|---|
| Podstawowe dane | Odległość i geometria | Obrazy |
| Praca bez światła widzialnego | Zwykle bardzo dobra | Klasyczna kamera RGB może mieć problem |
| Jednolite powierzchnie | Tekstura nie jest konieczna do pomiaru odległości | Feature-based vSLAM może mieć mało punktów charakterystycznych |
| Kolor i wygląd przedmiotu | Bardzo ograniczona informacja | Dużo informacji |
| Rozpoznawanie rodzaju obiektu | Ograniczone bez dodatkowych sensorów/algorytmów | Duży potencjał z computer vision |
| Niskie przeszkody | Klasyczny 2D LDS może je ominąć płaszczyzną skanowania | Kamera może je zobaczyć, jeśli znajdują się w jej polu widzenia |
| Zmiany oświetlenia | Znacznie mniejsza zależność od światła widzialnego | Mogą utrudniać śledzenie obrazu |
| Motion blur | Nie jest typowym problemem obrazu | Może pogorszyć tracking |
| Lustra i szkło | Możliwe fałszywe odległości i odbicia | Możliwe błędy wynikające z odbić i transparentności |
| Wysokość robota | Klasyczna wieżyczka LDS ją zwiększa | Kamerę łatwo zintegrować z korpusem |
| Dane o wyglądzie wnętrza | Brak klasycznych fotografii | Sensor rejestruje obraz sceny |
Ta tabela pokazuje typowe właściwości technologii, a nie gwarantowane zachowanie każdego robota.
Konkretne urządzenie może mieć dodatkowe sensory, własne oświetlenie, kilka kamer albo zupełnie inną architekturę systemu percepcji.
A co z prywatnością?
To jedna z najbardziej realnych różnic pomiędzy sensorem odległości i kamerą RGB.
Kamera może rejestrować obraz wnętrza.
Może znaleźć się na nim:
- człowiek,
- zwierzę,
- ekran komputera,
- dokument,
- prywatne wyposażenie domu.
LiDAR tworzy przede wszystkim dane geometryczne i nie wykonuje klasycznych fotografii.
Nie oznacza to jednak, że można automatycznie uznać każdy robot bez kamery za „całkowicie pozbawiony problemów prywatności”. Robot nadal może przetwarzać mapy mieszkania i inne dane.
W urządzeniach z kamerami kluczowe jest więc sprawdzenie:
- czy obrazy opuszczają urządzenie,
- czy są przechowywane,
- czy użytkownik może wyłączyć ich zapisywanie,
- jak producent zabezpiecza przesyłane dane.
Przykładowo iRobot deklaruje, że w funkcji Obstacle Image Review przesyłane obrazy są szyfrowane, a dostęp i czas przechowywania zależą od ustawień użytkownika i wyrażonych zgód.
Czy robot bez kamery jest zawsze lepszy dla prywatności?
Jeżeli kryterium brzmi wyłącznie:
„czy urządzenie może zrobić klasyczne zdjęcie mojego wnętrza?”
robot pozbawiony kamery RGB ma oczywistą przewagę.
Ale prywatność urządzenia IoT jest szerszym problemem.
Liczą się również:
- mapa mieszkania,
- dane konta,
- telemetria,
- połączenie z chmurą,
- zabezpieczenia aplikacji i serwerów.
Dlatego sensora nie należy utożsamiać z całą polityką bezpieczeństwa produktu.
Czy LiDAR jest dokładniejszy od vSLAM?
Nie da się uczciwie odpowiedzieć jednym „tak”.
LiDAR ma fundamentalną zaletę: dostarcza bezpośrednich pomiarów odległości.
To może zapewniać bardzo stabilną geometrię mapy w typowym środowisku wewnętrznym.
Ale jakość całego systemu zależy również od:
- dokładności sensora,
- częstotliwości pomiarów,
- odometrii,
- scan matchingu,
- loop closure,
- filtrowania błędnych punktów.
Visual SLAM również może osiągać bardzo wysoką dokładność, szczególnie w środowisku zawierającym dużo stabilnych informacji wizualnych.
Sama nazwa technologii nie pozwala więc przewidzieć dokładności całego robota.
Czy kamera jest tańsza?
Sam moduł kamery może być niewielki, tani i pozbawiony klasycznego mechanizmu obrotowego.
Ale sensor to tylko część kosztu.
Visual SLAM i rozpoznawanie obiektów wymagają przetwarzania:
- obrazów,
- cech wizualnych,
- modeli computer vision,
- czasem sieci neuronowych.
To oznacza zapotrzebowanie na odpowiednią moc obliczeniową, pamięć i oprogramowanie.
Dlatego nie ma sensu sprowadzać porównania do zdania:
„kamera jest tańsza niż LiDAR”.
Trzeba porównywać koszt całego systemu percepcji.
Co wybrać w praktyce?
Jeżeli patrzymy wyłącznie na główną lokalizację i mapowanie typowego mieszkania, LiDAR pozostaje bardzo wygodnym i przewidywalnym źródłem danych.
Szczególnie jeżeli:
- robot często pracuje wieczorem lub przy zgaszonym świetle,
- mieszkanie ma dużo jednolitych powierzchni,
- zależy nam na szybkim tworzeniu geometrycznej mapy.
System wizyjny zaczyna być szczególnie wartościowy tam, gdzie robot musi nie tylko wiedzieć, że coś przed nim jest, ale również próbować zrozumieć:
co przed nim leży.
Dlatego kamera ma ogromny sens przy:
- przewodach,
- butach,
- zabawkach,
- przedmiotach pozostawionych przez zwierzęta,
- bardziej semantycznym rozumieniu pomieszczenia.
Jeżeli miałbym wybierać: LiDAR czy kamera?
W przypadku współczesnego robota z wyższej półki odpowiedź brzmi:
najchętniej nie wybierałbym.
LiDAR i kamera rozwiązują częściowo inne problemy.
Laser jest świetnym źródłem geometrii.
Kamera dostarcza bogatej informacji wizualnej.
Sensor 3D może wypełnić przestrzeń pomiędzy nimi, dostarczając dokładniejszych danych o kształcie i wysokości przeszkody.
IMU i enkodery informują o ruchu urządzenia.
Połączenie tych danych może być odporniejsze niż próba rozwiązania wszystkich problemów jednym sensorem.
Największy błąd: oceniać nawigację po jednej pozycji w specyfikacji
Przy wyborze robota znacznie bardziej interesujące od pytania:
„ma LiDAR czy kamerę?”
są pytania:
- który sensor odpowiada za główną lokalizację?
- co odpowiada za wykrywanie małych przeszkód?
- czy robot potrafi działać w ciemności?
- czy kamera ma dodatkowe oświetlenie?
- czy główny LiDAR jest 2D czy system dostarcza dane 3D?
- jakie sensory pracują po schowaniu LiDAR-u pod meblem?
- czy kamera służy do vSLAM, czy wyłącznie do rozpoznawania przeszkód?
To ostatnie pytanie jest szczególnie ważne.
Robot może mieć jednocześnie LiDAR i kamerę, ale nadal nie wykorzystywać kamery jako głównego źródła dla vSLAM.
LiDAR vs vSLAM – kto więc wygrywa?
Jeżeli zmusimy się do wskazania przewagi w konkretnych zadaniach, można powiedzieć:
| Sytuacja | Typowa przewaga |
|---|---|
| Mapowanie w ciemności | LiDAR |
| Jednolita ściana bez tekstury | LiDAR |
| Bezpośredni pomiar odległości | LiDAR |
| Rozpoznanie buta lub przewodu | Kamera + computer vision |
| Informacja o kolorze i wyglądzie obiektu | Kamera |
| Bardzo niski robot bez wieżyczki | Kamera lub zintegrowany/solid-state LiDAR |
| Pełna percepcja współczesnego mieszkania | Połączenie kilku sensorów |
I właśnie ostatni wiersz jest najważniejszy.
Przyszłość to nie LiDAR kontra kamera
Jeszcze kilka lat temu łatwo było podzielić rynek na dwa obozy.
Dziś granice zaczynają znikać.
Roborock łączy LiDAR z kamerami RGB i sensorami 3D.
Dreame łączy dToF z kamerą AI oraz światłem strukturalnym.
iRobot po latach rozwoju vSLAM przeszedł w nowych generacjach do ClearView LiDAR, jednocześnie zachowując wizję komputerową w bardziej zaawansowanych modelach.
Najbardziej interesującym pytaniem przestaje więc być:
„laser czy kamera?”
A zaczyna:
„jak robot łączy dane z lasera, kamery, sensorów 3D, IMU i odometrii w jeden spójny obraz otoczenia?”
To właśnie nazywamy sensor fusion.
W ostatniej części tej serii pokazujemy już cały system razem: jak robot łączy LiDAR, kamerę, ToF, IMU i odometrię oraz dlaczego jakość współpracy sensorów może być ważniejsza niż ich liczba.
Najważniejsze wnioski
- LiDAR jest sensorem, a vSLAM jest metodą lokalizacji i mapowania wykorzystującą dane wizualne.
- Klasyczny LiDAR dostarcza bezpośredniej informacji o odległości, podczas gdy kamera monocularna musi wnioskować o geometrii na podstawie obrazów i ruchu.
- Feature-based vSLAM potrzebuje charakterystycznych elementów obrazu i może mieć trudności w środowisku o małej teksturze.
- Zwykła kamera RGB jest bardziej zależna od oświetlenia niż LiDAR.
- LiDAR ma ograniczone informacje o wyglądzie i rodzaju obiektu.
- Kamera może wspierać rozpoznawanie butów, przewodów czy innych przeszkód, ale samo vSLAM nie jest systemem klasyfikacji obiektów.
- Klasyczny 2D LiDAR może nie zobaczyć niskiej przeszkody znajdującej się poza jego płaszczyzną skanowania.
- Zarówno LiDAR, jak i systemy wizyjne mogą mieć problemy z lustrami i szkłem, choć mechanizm błędu jest inny.
- Współczesne roboty coraz częściej łączą LiDAR, kamerę, sensory 3D, IMU i odometrię.
- Dlatego o jakości nawigacji nie powinno się decydować na podstawie jednego skrótu w specyfikacji.
FAQ – LiDAR vs vSLAM
Co jest lepsze w robocie sprzątającym: LiDAR czy vSLAM?
Nie ma uniwersalnego zwycięzcy. LiDAR ma dużą przewagę w bezpośrednim pomiarze geometrii i pracy bez światła widzialnego, natomiast kamera dostarcza znacznie więcej informacji o wyglądzie otoczenia. W zaawansowanych robotach najlepsze efekty coraz częściej daje połączenie kilku sensorów.
Czy vSLAM działa po ciemku?
Klasyczny vSLAM oparty na zwykłej kamerze RGB potrzebuje wystarczającej ilości światła, aby uzyskać użyteczny obraz. System wyposażony w dodatkowe oświetlenie, podczerwień lub inne sensory może jednak działać również w warunkach, w których zwykła kamera miałaby problemy.
Czy LiDAR działa w całkowitej ciemności?
Tak, typowy LiDAR nie potrzebuje światła widzialnego w pomieszczeniu, ponieważ emituje własne promieniowanie wykorzystywane do pomiaru odległości. Dlatego zgaszenie oświetlenia zwykle nie uniemożliwia mu mapowania.
Czy robot z kamerą rozpoznaje przedmioty?
Nie automatycznie. Kamera dostarcza obraz, ale do rozpoznawania rodzaju przedmiotów potrzebne są odpowiednie algorytmy computer vision lub modele AI. Kamera wykorzystywana do vSLAM może służyć przede wszystkim lokalizacji, a nie klasyfikacji przeszkód.
Czy robot z LiDAR-em może mieć również kamerę?
Tak. Jest to obecnie bardzo popularne rozwiązanie. LiDAR może odpowiadać za główną lokalizację i mapowanie, podczas gdy kamera wspiera rozpoznawanie przeszkód i analizę otoczenia.
Dlaczego kamera ma problem z białą ścianą?
Jednolita powierzchnia może zawierać niewiele charakterystycznych cech potrzebnych feature-based vSLAM do śledzenia ruchu pomiędzy kolejnymi obrazami. LiDAR nie potrzebuje tekstury, aby zmierzyć odległość do ściany.
Czy LiDAR zawsze lepiej mapuje korytarz?
Nie zawsze. LiDAR dobrze mierzy geometrię ścian, ale bardzo długi i powtarzalny korytarz może dostarczać mało unikalnej informacji pozwalającej określić ruch wzdłuż jego osi. Dlatego system korzysta również z odometrii, IMU i kolejnych pomiarów.
Czy kamera jest zagrożeniem dla prywatności?
Kamera może rejestrować klasyczny obraz wnętrza, dlatego sposób przetwarzania i przechowywania danych ma znaczenie dla prywatności. Nie oznacza to jednak, że każdy robot z kamerą przesyła lub przechowuje fotografie – zależy to od konkretnego urządzenia, funkcji i polityki producenta.
Czy robot bez kamery jest bezpieczniejszy dla prywatności?
Nie może wykonywać klasycznych zdjęć za pomocą kamery, ale nadal może przetwarzać mapę mieszkania, dane urządzenia i telemetrię. Prywatność trzeba więc oceniać na poziomie całego produktu i usług producenta.
Dlaczego nowe roboty mają jednocześnie LiDAR i kamerę?
Ponieważ sensory dostarczają różnych informacji. LiDAR dobrze opisuje geometrię i odległość, kamera dostarcza informacji wizualnych, a sensory 3D mogą dokładniej określać kształt przeszkód. Połączenie tych danych pozwala stworzyć bardziej kompletny system percepcji.
Źródła
- Visual-SLAM Classical Framework and Key Techniques: A Review
- A Review on Visual-SLAM: Advancements from Geometric Modelling to Learning-Based Semantic Scene Understanding Using Multi-Modal Sensor Fusion
- ORB-SLAM: A Versatile and Accurate Monocular SLAM System
- Visual and Visual–Inertial SLAM for UGV Navigation in Unstructured Natural Environments: A Survey of Challenges and Deep Learning Advances
- A Review of Simultaneous Localization and Mapping Algorithms Based on Lidar
- Roomba 980 Media Kit – Visual Simultaneous Localization and Mapping
- iAdapt 3.0 Navigation Technology and Imprint Smart Maps
- Roomba is missing spots, not cleaning the entire area, or does not cover the whole home
- Camera, PrecisionVision and Obstacle Image Review
- iRobot Redefines Floor Care with a New Generation of Roomba Robots
- Roborock StarSight Autonomous System
- What is the Reactive AI 2.0 Obstacle Recognition Tech?
- Dreame X50 Ultra